买服务器这事,跟买手机不太一样。手机拿到手开个机,滑两下屏幕,好不好用心里大概就有数了。服务器不是这样。刚开通那天,系统干净、负载为零、缓存还没堆起来,SSH 敲下去秒回,网站点开就加载完。这个状态会持续几天,甚至一两周。很多人就是在这个阶段觉得“这台机器稳了”,然后就把年费付了。
但真正的问题,往往要在服务器连续跑上两三个月之后才会慢慢浮出来。
我手头有一台 LuckVM 的香港云服务器,1 核 CPU、1GB 内存、60GB SSD 硬盘、10M 带宽。配置不算高,就是普通入门款。我把它挂了一个外贸展示站加一个轻量 API 服务,没有刻意去折腾它,也没有频繁重装系统,就让它像正常项目一样每天在线。到现在跑了快三个月,中间经历了几次晚高峰、几次备份操作、几次流量小高峰。有些体验确实是第一天看不出来的。
刚买时快,不代表三个月后还快
刚开通那阵子,这台机器的表现确实漂亮。香港节点走的是 BGP 加 CN2 GIA 三线优化,晚高峰丢包率压到了 2.3% 左右,延迟稳定在 15 到 20 毫秒。从国内任何一个地方连过去,体感跟连国内机房差不了太多。SSH 敲命令没有那种“等一拍”的感觉,网页加载也利索。
但这个状态维持了大概三周。之后网站访问量慢慢上来了一点,数据库里的记录多了,日志文件开始堆积,Docker 容器跑起来之后缓存也在涨。到了第 40 天左右,我发现后台保存文章的时候偶尔会卡那么一两秒。不是每次都有,但隔几天就会出现一次。SSH 登录的响应也不像刚开始那样干脆了,偶尔会有半秒的延迟。
问题出在哪儿?不是 CPU 不够用,也不是带宽被占满了。是内存慢慢被吃掉了。Web 服务、数据库、缓存、日志收集、监控脚本,每一个单独看都不大,但加在一起就挤得慌。1GB 的内存跑这些东西,刚开机的时候可能还剩 600MB 多,跑到第 60 天的时候,常驻内存占用已经到了 850MB 左右。系统开始频繁用 swap,磁盘 IO 也跟着上来了。这就是那种“说不清哪里慢,但就是没以前顺”的感觉。
磁盘 IO 平时不显眼,关键时刻很要命
这台机器的硬盘是 60GB SSD,容量对于一个小型外贸站加 API 服务来说本来是够的。但跑了两个月之后,我发现磁盘空间掉得比预想中快。网站访问日志一天天在涨,数据库备份每周自动打一个包,Docker 镜像拉了几次之后旧的没删干净,再加上系统更新留下的缓存,60GB 慢慢就只剩不到 15GB 了。
真正让我注意到磁盘 IO 的是一次备份操作。那天晚上我手动触发了一次数据库全量备份,同时网站那边正好有几个访客在提交表单。备份跑了大概三分钟,那三分钟里后台保存文章明显变慢,前台页面加载也拖了节奏。不是网站挂掉了,就是那种“卡一下、缓一下”的感觉。后来查了一下,是备份期间磁盘读写排队了。
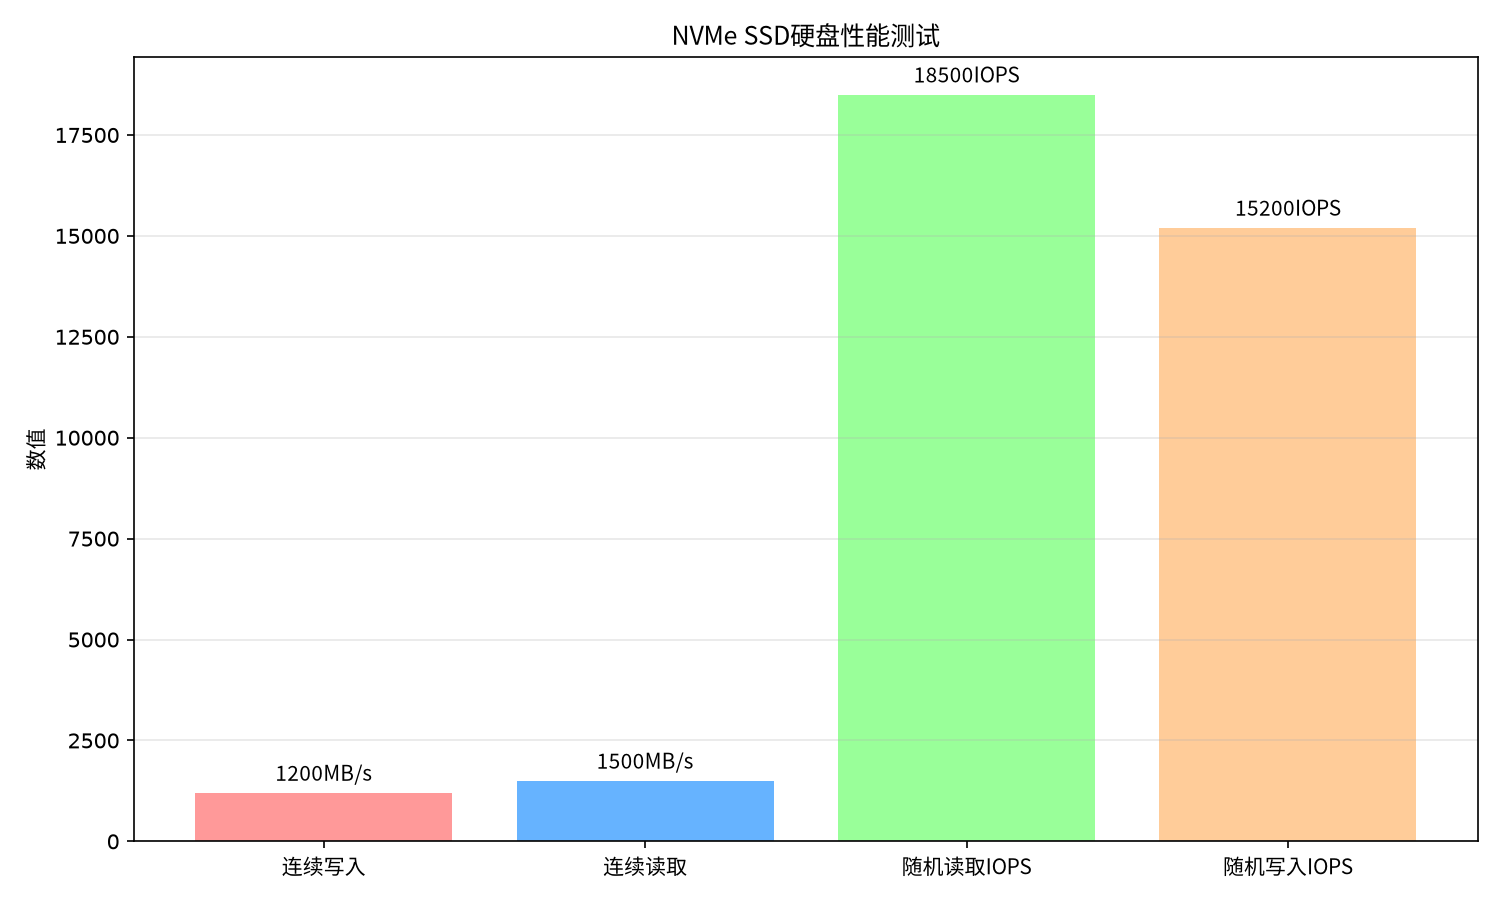
LuckVM 的香港节点在磁盘这块用的是 SSD,日常读写表现中规中矩。但对于跑数据库、跑 Docker 这类对 IO 敏感的业务来说,还是要留点余量。不能光看套餐页上写的“SSD”三个字就觉得万事大吉,实际跑起来之后,日志增长、备份频率、缓存策略这些都会影响磁盘的体验。
晚高峰的稳定,比白天的测速值重要
这台机器白天测速一直不错。不管是电信还是联通,从国内各地 ping 过去基本都是 20 毫秒上下,丢包率几乎为零。但到了晚上 8 点到 11 点这个时段,情况会有一些细微的变化。
丢包率从 0 涨到了 2% 左右,延迟从 15 毫秒跳到 25 到 30 毫秒。数字上看好像差别不大,但实际体感是 SSH 偶尔会出现那种“敲了回车等半秒才回显”的情况。网页打开的速度也从“秒开”变成了“等一个呼吸的时间”。不是不能用,但你能明显感觉到网络在高峰期的承压。
LuckVM 香港节点的 BGP 多线智能调度系统在平时能把跨国路由的跳转节点压缩到比较少的数量。但晚高峰时期,国际带宽的整体拥堵是客观存在的,再好的调度也只能缓解,不能完全消除。所以判断一台机器能不能长期用,不能只看白天测速跑出来的漂亮数字,要看晚上 10 点的时候它还能不能稳住。
GPU 服务器的算力,按需调用的逻辑不一样
除了云服务器,LuckVM 还做 GPU 显卡服务器,提供 NVIDIA A100、H100 和 RTX 系列显卡。A100 有 80GB 显存,H100 走的是顶级算力路线,RTX 系列主打性价比。这类机器和普通云服务器的使用逻辑不太一样。
普通云服务器买了就开着,一直在线。GPU 服务器很多场景是按需调用的。训练一个模型可能跑几十个小时,训完了就关机,下次用再开。LuckVM 在这块支持按小时计费,预装了深度学习框架。对于做 AI 训练、深度学习、渲染计算这类业务的团队来说,这种计费方式比较灵活。不需要为一整台机器付月租,用多少小时算多少小时。
但这里也有一个长期使用才会碰到的问题:数据怎么存。GPU 服务器关机之后,系统盘里的数据还在不在、下次开机能不能直接接着跑,这些细节在购买的时候不容易注意到。如果训练数据和模型权重都放在系统盘里,关机再开可能就没了。所以用 GPU 服务器的时候,需要把数据单独挂载到持久化存储上,或者配合对象存储来用。这些事不是第一天就能想到的,往往要经历过一次“数据丢了”或者“重头再跑”之后才会重视起来。
物理服务器是另一个逻辑
LuckVM 也提供物理服务器,走的是独享资源路线。100% 独享物理资源,企业级硬件配置,带 RAID 磁盘阵列保护和 IPMI 远程管理。这类产品面向的是大流量、高并发、数据库这类核心业务。
物理服务器和云服务器最大的区别在于,你不用跟别人抢资源。宿主机上只有你一家,CPU、内存、磁盘 IO、网络带宽都是你的。长期跑下来,性能曲线是一条平稳的直线,不会出现“白天挺好、晚上邻居把 CPU 占满了导致你也卡”的情况。
但物理服务器的维护成本也更高。系统更新、安全补丁、硬件故障排查,这些都得自己盯着。云服务器出了问题可以一键重装、快照恢复,物理服务器出了问题要走的流程更重。所以在选物理机之前,要先想清楚:你的业务是不是真的需要独享硬件,还是说云服务器的弹性其实已经够用了。
选节点这件事,不能只看名字
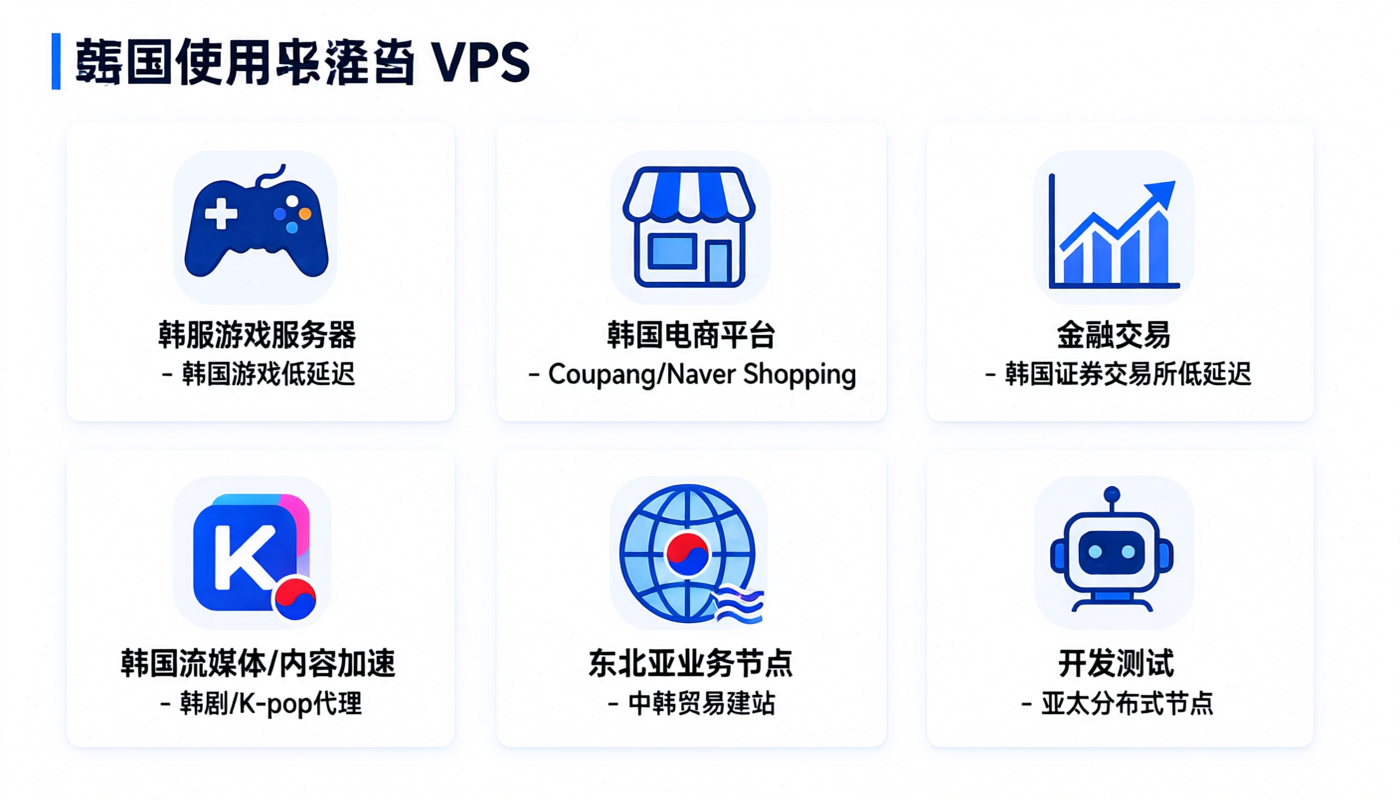
LuckVM 覆盖了 40 多个国家和地区,香港、美国、日本、韩国、新加坡、马来西亚、台湾、越南都有节点。不同节点的定位不一样。
香港节点延迟最低,10 毫秒以内,CN2 GIA 直连。面向国内用户的首选。日本东京和大阪双节点,延迟 50 毫秒以内,BGP 多线接入。适合面向东亚市场的业务。美国洛杉矶和圣何塞节点,CN2 优化回国线路,延迟 160 毫秒以内。面向北美市场或者全球分发的业务可以选这里。新加坡延迟 70 毫秒以内,国际 BGP 带宽充裕。东南亚业务的枢纽。韩国首尔走 KT/SK 线路。台湾台北延迟 30 毫秒以内。越南胡志明市 80 毫秒以内。
选哪个节点,取决于你的用户在哪儿。面向国内用户,香港是最稳的。面向东南亚,新加坡和越南更合适。面向全球,美国西海岸是标配。不要只看哪个节点便宜就选哪个,线路质量和用户距离才是长期体验的决定因素。
域名注册顺手办了,省一个平台
LuckVM 还做域名注册,支持 .com、.net、.cn 等几百种域名后缀。实时查询、即时注册,带免费的 DNS 智能解析和 WHOIS 隐私保护。
对于已经在 LuckVM 上买了服务器、跑了业务的用户来说,域名注册算是一个顺手就能办的事。不用再单独去另一个平台注册域名、再把 DNS 指向过来。一个后台把服务器和域名一起管了,省掉一些跨平台操作的麻烦。
三个月之后,我更关注这些
跑了快三个月之后,我对这台机器的判断标准有些变化。
刚开始我只关心延迟多少、带宽多大、价格便不便宜。现在我会更在意它在持续运行中的表现。晚高峰的时候网络波动大不大,磁盘空间增长快不快,内存占用有没有慢慢往上爬,重启之后服务能不能自动恢复。这些东西比单次测速更真实。
这台 LuckVM 的香港入门机,整体表现算是稳的。晚高峰会有波动,但没断过;内存会慢慢吃紧,但通过调整缓存策略和定期清理日志能缓解;磁盘 IO 在备份的时候会有压力,但日常使用感受不明显。对于一个小型外贸站加轻量 API 服务的组合来说,它撑住了三个月的持续运行。
但我也意识到一件事:长期稳定不光是靠机器本身,也靠日常管理。日志要定期清理,备份要检查是否成功,磁盘空间要盯着,安全更新要及时打。服务器不是买完就结束的,它是一个需要持续照顾的小系统。
新手买服务器,别只看宣传页
厂家宣传页上写的东西当然要看,但那些通常是最容易展示的部分。CPU 型号、内存大小、带宽数值、机房位置,这些写在页面上很直观。但真正影响长期体验的东西,往往不会写得很细。
晚高峰的线路质量、磁盘 IO 的稳定性、宿主机上的邻居吵不吵、售后工单回复快不快、出了问题能不能及时处理,这些都要靠实际使用才能慢慢摸清楚。
所以我的建议是:先用短周期、小配置跑一段时间。项目跑起来之后,观察它在第 30 天、第 60 天、第 90 天的表现,再决定要不要续费、升级或者迁移。先验证,再长期投入,比一开始就被低价套餐吸引着买一年更稳。