2026年,AI应用全面爆发——Stable Diffusion图像生成、LLaMA/ChatGLM大语言模型、AI视频生成、3D渲染、科学计算……这些任务的共同特点是:需要GPU并行计算能力。普通CPU服务器跑一个7B模型推理可能卡顿到无法使用,而一张RTX 4090可以秒级响应。
但GPU服务器价格不菲(月费从数百元到数万元不等),选错型号轻则浪费钱,重则显存不足直接跑不起来。这篇指南从基础概念→型号对比→显存选择→场景匹配→环境搭建→成本优化全流程讲解,帮你用最划算的价格选到最合适的GPU服务器。
一、GPU服务器到底是什么?和普通VPS有什么区别
很多用户第一次接触GPU服务器时都会问:我有普通的VPS/云服务器,为什么还需要GPU?答案很简单——CPU和GPU的设计目标完全不同。
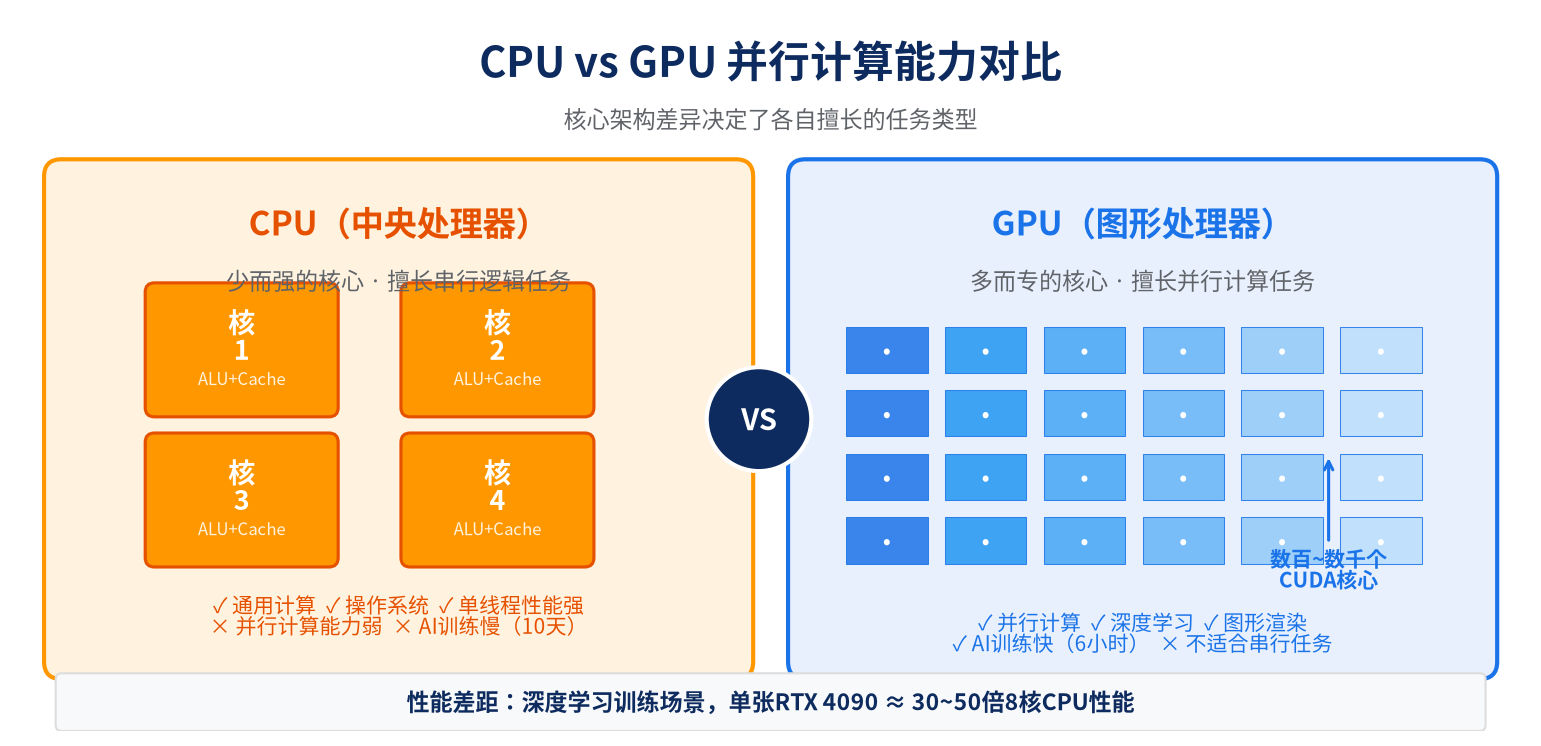
图1:CPU与GPU核心架构对比——少而强 vs 多而专
简单理解:
- CPU(中央处理器):像几个"博士生",每个核心非常强,擅长复杂的逻辑运算、串行任务——适合跑网站、数据库、操作系统。
- GPU(图形处理器):像几千个"小学生",每个核心简单,但可以同时做一件事——适合矩阵运算(AI训练)、像素处理(图像渲染)。
深度学习模型训练场景:8核CPU训练一个中等模型需要10天,单张RTX 4090仅需6小时——性能差距约30~50倍。Stable Diffusion 512×512图像生成,CPU需要几十秒一张,GPU仅需2~5秒。
但GPU不是万能的。它不适合串行任务(建站、数据库、API服务),这些场景用普通CPU VPS更划算。GPU服务器的核心价值是AI训练/推理、图形渲染、视频处理、科学计算等并行计算密集型场景。
二、主流GPU显卡型号全对比
选GPU服务器,第一个要决定的就是显卡型号。NVIDIA是AI计算的绝对主流(CUDA生态垄断),LuckVM提供的也是NVIDIA全系列显卡。下面是各型号的详细对比:
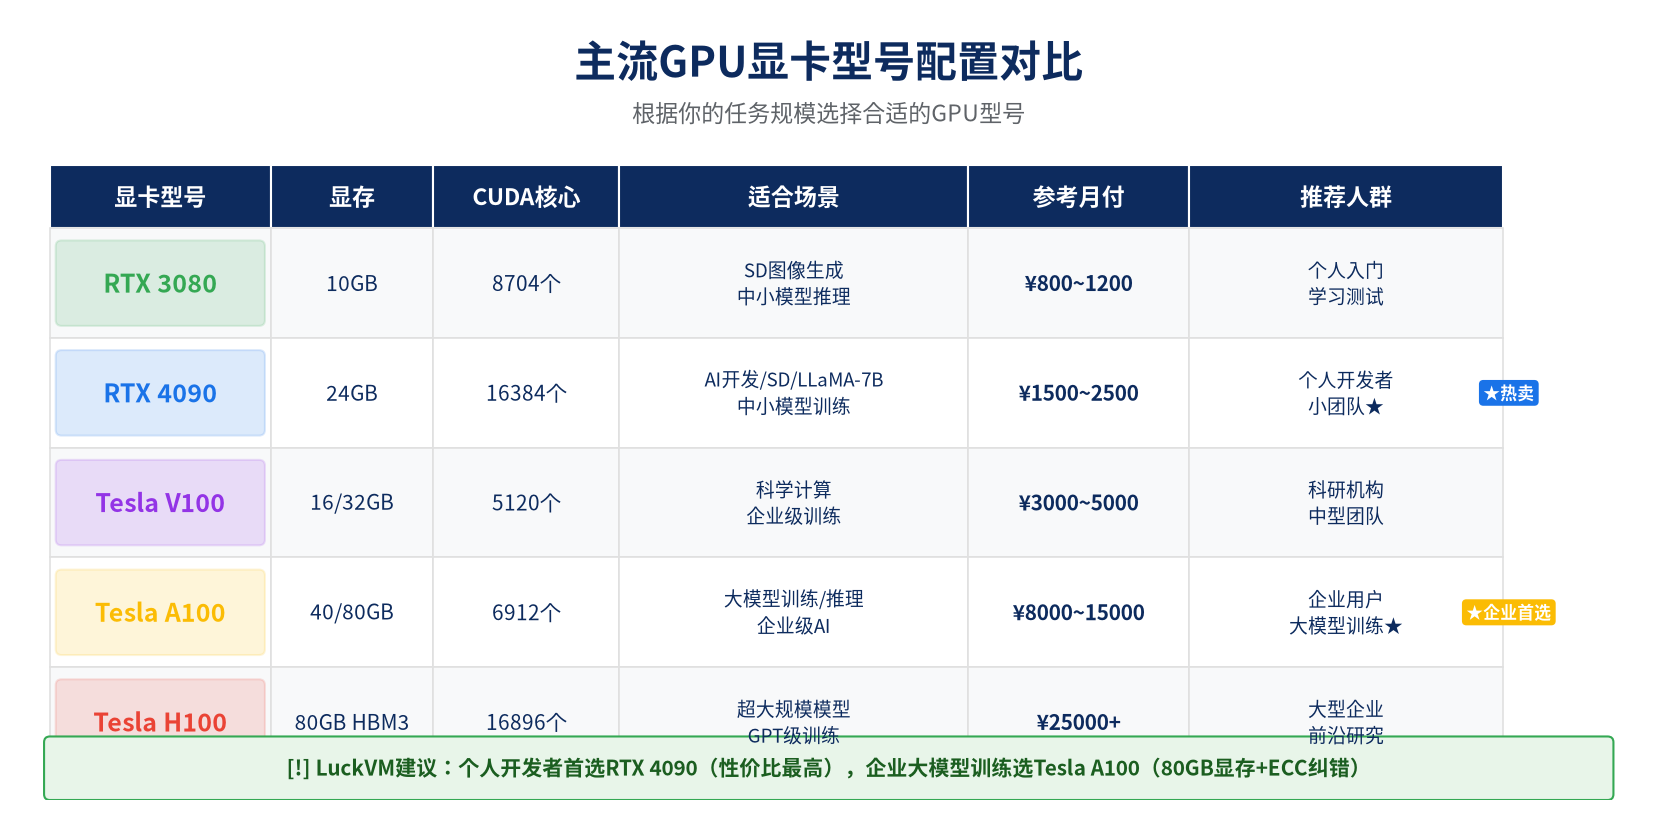
图2:主流GPU显卡配置、场景、价格对比
🔹 RTX 3080(10GB)——入门体验级
适合完全刚入门AI、想体验Stable Diffusion出图或者学习深度学习的用户。10GB显存可以跑SD 1.5、做简单的图像生成和小型模型推理,但不适合训练和大模型。月费约¥800~1200,门槛最低。
🔹 RTX 4090(24GB)——个人开发者性价比之选 ⭐最推荐
2026年个人和小团队最推荐的型号。24GB显存可以覆盖绝大多数个人/小团队场景:Stable Diffusion XL出图、LLaMA-2/ChatGLM-7B/13B推理、LoRA微调、小规模模型训练。游戏级显卡但AI计算能力非常强悍(16384个CUDA核心),月费仅¥1500~2500,性价比远超Tesla系列。
RTX 4090是LuckVM最受欢迎的GPU型号,适合90%以上的个人AI开发者。提供香港和美国双机房,按小时低至$3~5/小时,包月低至$264/月,预装CUDA+PyTorch镜像,开通即用。
🔹 Tesla V100(16/32GB)——科研计算级
NVIDIA的经典计算卡,支持ECC纠错内存(数据训练不因为显存位错误出问题),双精度计算能力强,适合科学计算、分子模拟、传统机器学习算法。但在AI推理/训练场景性价比不如RTX 4090(核心数少、价格更高)。月费约¥3000~5000。
🔹 Tesla A100(40/80GB)——企业级大模型训练 ⭐企业首选
企业级AI训练的标准配置。40GB/80GB大显存+ECC纠错+NVLink多卡互联,可以跑70B参数级别的大模型(LLaMA-2 70B、GPT级模型),支持多卡分布式训练。月费¥8000~15000,适合企业、研究机构、AI创业公司。
🔹 Tesla H100(80GB HBM3)——超大规模训练
NVIDIA当前最顶级的数据中心GPU。采用Hopper架构,HBM3高速显存,Transformer引擎专门为大模型训练优化,AI算力是A100的3~6倍。适合训练百亿/千亿参数大模型(GPT-4级别)。月费¥25000+,面向大型企业和前沿研究机构。
三、显存是关键——常见AI任务到底需要多少显存
选GPU最容易犯的错误就是显存买小了。显存不够,程序直接报错"CUDA out of memory",根本跑不起来。不同任务的显存需求差异巨大,下图是常见AI任务的显存需求参考:
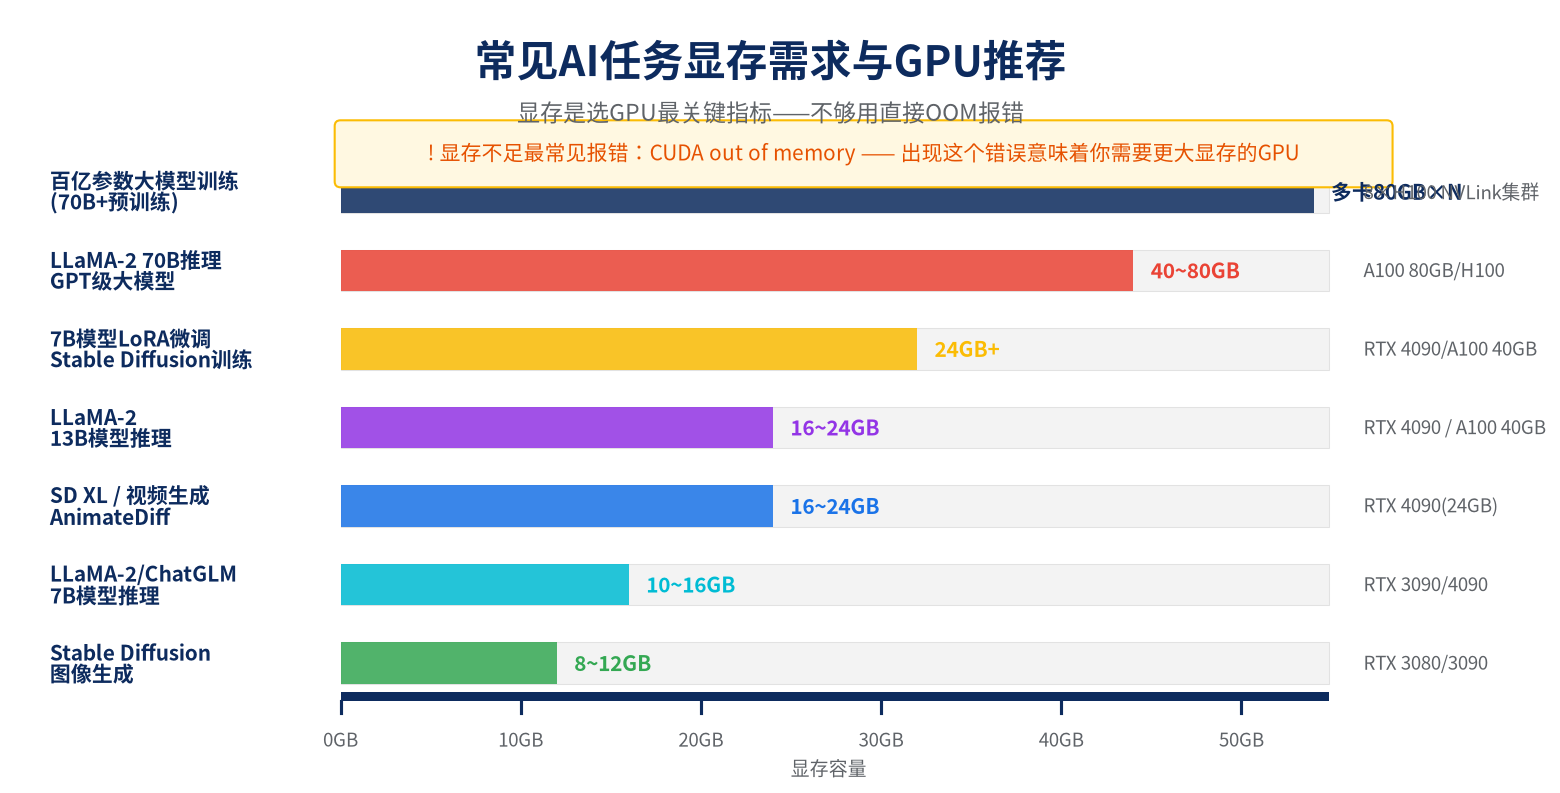
图3:常见AI任务显存需求与对应GPU推荐
| 任务类型 | 最低显存 | 推荐GPU | 说明 |
|---|---|---|---|
| Stable Diffusion 1.5 出图 | 8GB | RTX 3080 | 512×512约2~5秒/张 |
| Stable Diffusion XL 出图 | 12GB | RTX 3090/4080 | 1024×1024高质量图 |
| LLaMA-2 7B 推理 | 10~16GB | RTX 3090/4090 | INT4量化可在8GB运行 |
| ChatGLM3-6B 推理 | 8~13GB | RTX 3080/4090 | 中文对话模型 |
| LLaMA-2 13B 推理 | 16~24GB | RTX 4090(24GB) | 对话效果更流畅 |
| 7B模型LoRA微调 | 24GB | RTX 4090/A100 | 微调自己的专属模型 |
| LLaMA-2 70B 推理 | 40~80GB | A100 80GB | 需多卡或量化 |
| 70B+模型预训练 | 多卡80GB×N | 8×H100 NVLink | 企业级集群训练 |
| 视频生成(AnimateDiff) | 16~24GB | RTX 4090 | AI短视频生成 |
| 3D渲染/Blender GPU渲染 | 12~24GB | RTX 4090 | 渲染速度比CPU快10~20倍 |
有三个方案:
① 量化:使用INT4/INT8量化(如GPTQ、AWQ、bitsandbytes),显存需求可减少50~75%,精度损失很小;
② 梯度检查点:训练时使用gradient_checkpointing,用计算时间换显存空间;
③ 升级GPU:最根本的方案,更大显存可以跑更大的模型、更大的batch size,训练速度也更快。
四、香港GPU vs 美国GPU:机房怎么选
LuckVM提供香港GPU服务器和美国GPU服务器两个机房,两者各有优势,选择取决于你的使用场景:
| 对比项 | 🇭🇰 香港GPU服务器 | 🇺🇸 美国GPU服务器 |
|---|---|---|
| 国内延迟 | 5~30ms(极快) | 150~220ms |
| 带宽 | 100Mbps~1Gbps优化带宽 | 1~10Gbps大带宽 |
| 价格 | 略高 | 更实惠 |
| 网络线路 | CN2 GIA三网直连回国 | 国际带宽充足 |
| 适合场景 | Jupyter交互式开发、国内团队协作、API在线推理、频繁远程操作 | 大规模数据训练、批量任务、长时间后台运行、对延迟不敏感 |
| 开通速度 | 5~10分钟自动开通 | 5~10分钟自动开通 |
如果你在国内,需要频繁连接Jupyter Notebook写代码、调试模型——选香港GPU,延迟低、操作流畅,不会有卡顿感。
如果你要跑长时间训练任务(数天到数周)、上传下载大数据集——选美国GPU,带宽大、价格更划算,延迟不影响训练任务。
五、LuckVM GPU服务器热门套餐推荐
LuckVM提供香港GPU服务器和美国GPU服务器,搭载RTX/Tesla系列专业显卡,预装CUDA与PyTorch环境,支持按小时和按月灵活计费,专为AI训练、深度学习与3D渲染设计。
CUDA核心:16384个
CPU/内存:16核vCPU / 64GB DDR5
存储:1TB NVMe SSD(读写3500MB/s+)
带宽:香港CN2 GIA / 美国1Gbps大带宽
系统:Ubuntu 22.04 + 预装CUDA 12 + PyTorch 2.x
CUDA核心:6912个 + 432个Tensor核心
CPU/内存:32核vCPU / 128~256GB DDR4 ECC
存储:2TB NVMe SSD
特性:ECC纠错内存、支持NVLink多卡互联
适用:大模型训练、企业级AI推理
除上述套餐外,LuckVM还提供RTX 3080入门套餐、Tesla V100科研套餐、H100顶级训练套餐,以及多GPU(2~8卡)NVLink互联方案,支持按需定制配置。如需定制配置,可联系客服一对一方案。
六、5步搭建AI环境:从购买到开始训练
LuckVM GPU服务器的一大优势是开箱即用——我们提供预装AI环境的镜像,购买后最快5分钟即可开始训练,不需要自己花几小时装CUDA、编译PyTorch。
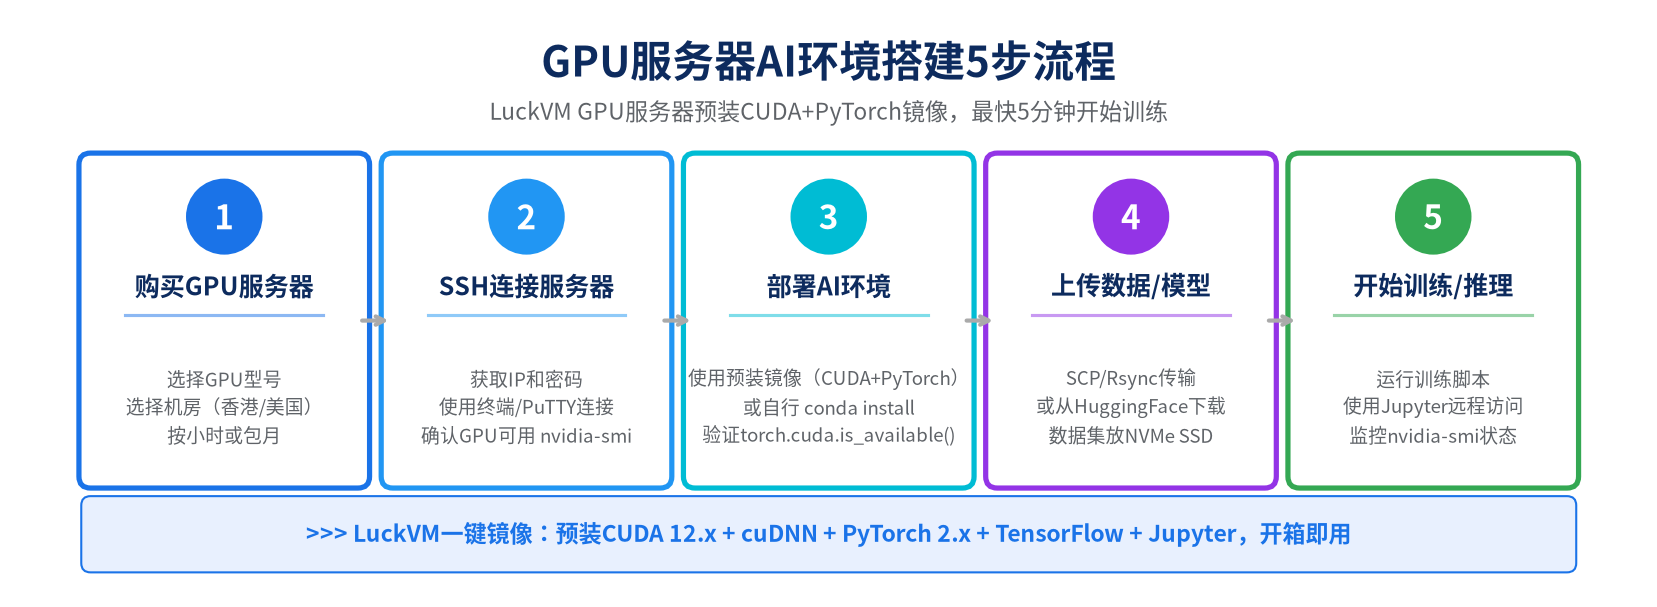
图4:GPU服务器AI环境搭建5步流程
第一步:购买GPU服务器
前往GPU服务器产品页,选择GPU型号、机房(香港/美国)、计费方式(按小时/包月)、操作系统(推荐选"AI预装镜像"),完成支付后等待开通。标准配置5~10分钟自动开通,开通信息(IP、端口、密码)会发送到你的邮箱和控制台。
第二步:SSH连接服务器
使用终端(macOS/Linux)或PuTTY/Windows Terminal(Windows)通过SSH连接:
执行nvidia-smi后应该看到GPU型号、显存大小、CUDA版本等信息,这说明GPU已正常驱动。
第三步:验证AI环境
如果你选择了AI预装镜像,CUDA、cuDNN、PyTorch、TensorFlow等环境已经配置好,直接验证:
第四步:上传数据集或模型
可以通过以下方式传输数据:
- SCP/SFTP:小文件直接用scp命令或FileZilla上传
- Rsync:大文件/增量传输推荐rsync(断点续传)
- 直接下载:从HuggingFace、GitHub等直接在服务器上wget/git clone(速度更快)
- 对象存储:大数据集建议先传到对象存储,服务器内网高速下载
第五步:开始训练/推理
推荐使用Jupyter Notebook/Lab进行交互式开发(预装镜像已包含)。启动后在本地浏览器通过SSH隧道访问:
训练过程中持续运行watch -n 1 nvidia-smi监控GPU利用率和显存占用;使用tmux或screen保持SSH断开后训练进程不中断;推荐安装nvitop(更美观的GPU监控工具)实时查看状态。
七、按小时还是包月?计费方式和成本优化
GPU服务器不便宜,合理选择计费方式可以省下不少钱。LuckVM提供按小时计费和按月/按年计费两种方式:
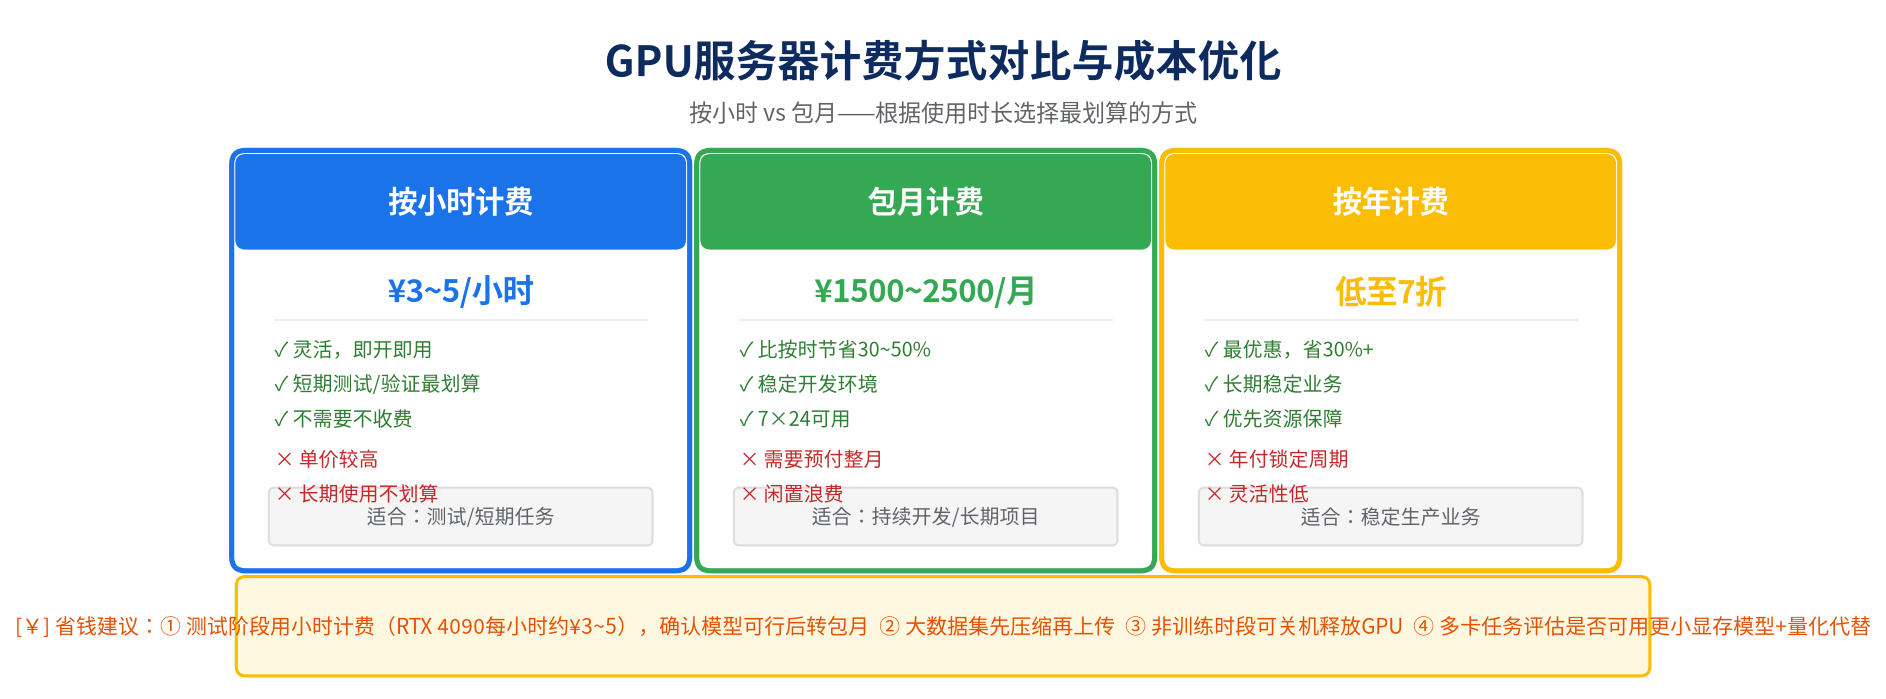
图5:三种计费方式对比与成本优化建议
💰 四个省钱技巧
- 测试阶段用小时计费:RTX 4090每小时约¥3~5,花几十块钱测试环境、跑通代码、验证模型可行,确认没问题再转包月。
- 月使用超200小时选包月:包月价格比按时计费节省30~50%,如果你每天用8小时以上,包月明显更划算。LuckVM支持灵活切换。
- 非训练时段关机:按小时计费时,不用时在控制台关机即可停止计费(注意:存储数据保留,下次开机数据还在)。
- 用模型量化减少显存需求:通过GPTQ/AWQ量化把7B模型压缩到INT4精度,原本需要24GB显存的任务12GB就能跑,可以选更便宜的GPU型号。
按小时计费关机后,公网IP可能会释放(不同服务商政策不同);包月/包年实例IP固定。如果你的服务需要固定IP提供API访问,建议包月。LuckVM包月实例均提供固定IP。
八、常见问题FAQ
🚀 立即开始你的AI开发之旅
LuckVM GPU服务器,RTX 4090 低至$264/月,预装CUDA+PyTorch开箱即用
香港/美国双机房可选,按小时/包月灵活计费,7×24小时中文技术支持