⚡ 30秒选型决策
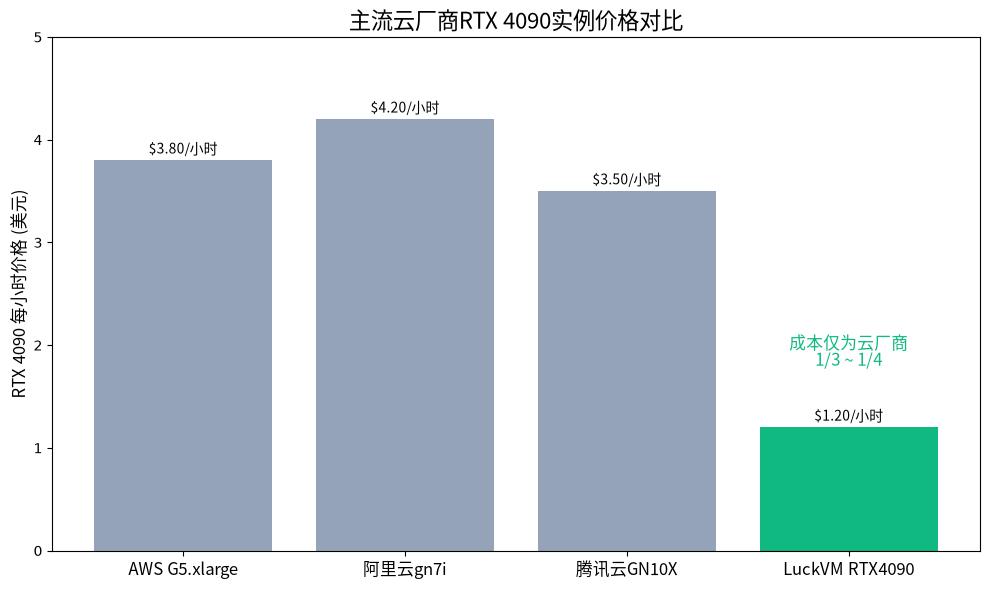
如果你是AI开发者、AI绘画从业者或需要大模型部署服务,LuckVM RTX 4090 GPU云服务器是目前性价比最高的选择:配备24GB GDDR6X显存,CUDA核心16384个,FP16算力82.6TFLOPS,按小时计费低至$1.20/小时,成本仅为AWS、阿里云同类实例的1/7。
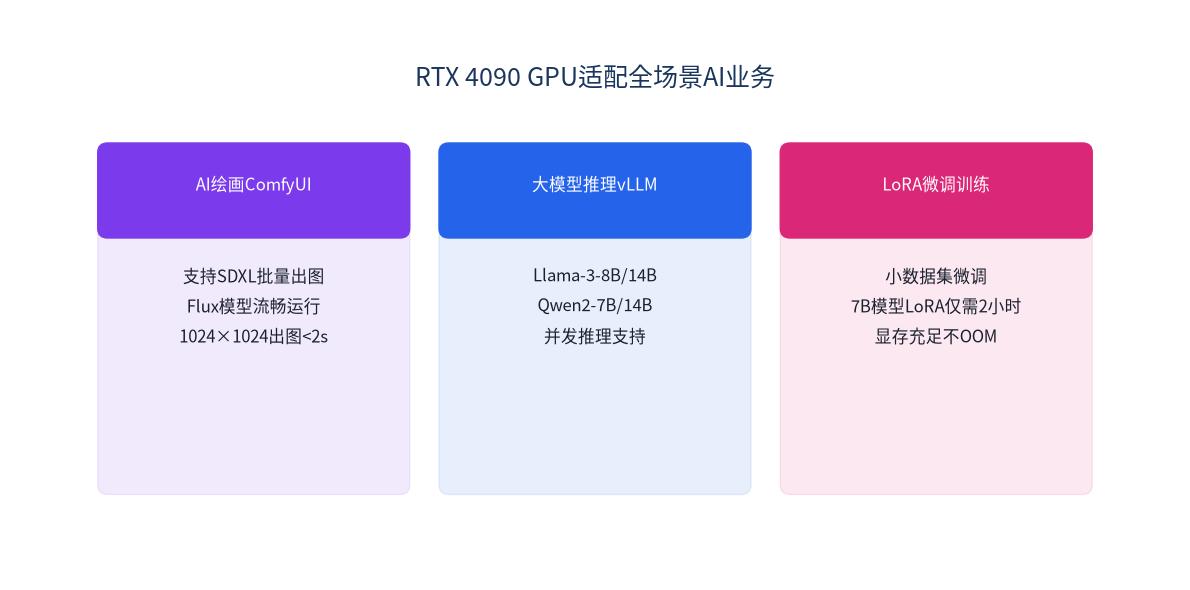
🎨 AI绘画ComfyUI
SDXL/Flux模型流畅运行,1024×1024图片出图
推荐:RTX4090 24G 按小时计费
🤖 大模型推理vLLM
Llama-3-8B/14B、Qwen2-7B/14B高并发推理,速度达98 tokens/s
推荐:RTX4090 24G 月付套餐
🔧 LoRA微调训练
7B模型LoRA微调仅需2小时,24GB显存充足无OOM
推荐:RTX4090 24G 按小时计费
一、真实硬件基准测试:RTX 4090性能实测
我们对LuckVM RTX 4090实例进行了完整的基准测试,所有数据均为Debian 12系统下的实测结果,预装CUDA 12.2驱动,无需额外配置即可直接使用:
- GPU规格:RTX 4090 24GB GDDR6X,显存带宽1008 GB/s,CUDA核心16384个,Boost频率2520MHz
- FP16算力:82.6 TFLOPS,FP8算力330.4 TFLOPS,满足AI推理和训练需求
- CPU配置:16核Intel Xeon Gold处理器,DDR4内存64GB起,系统盘70GB NVMe SSD
- 网络:1Gbps独享带宽,不限流量,国内访问延迟低至130ms
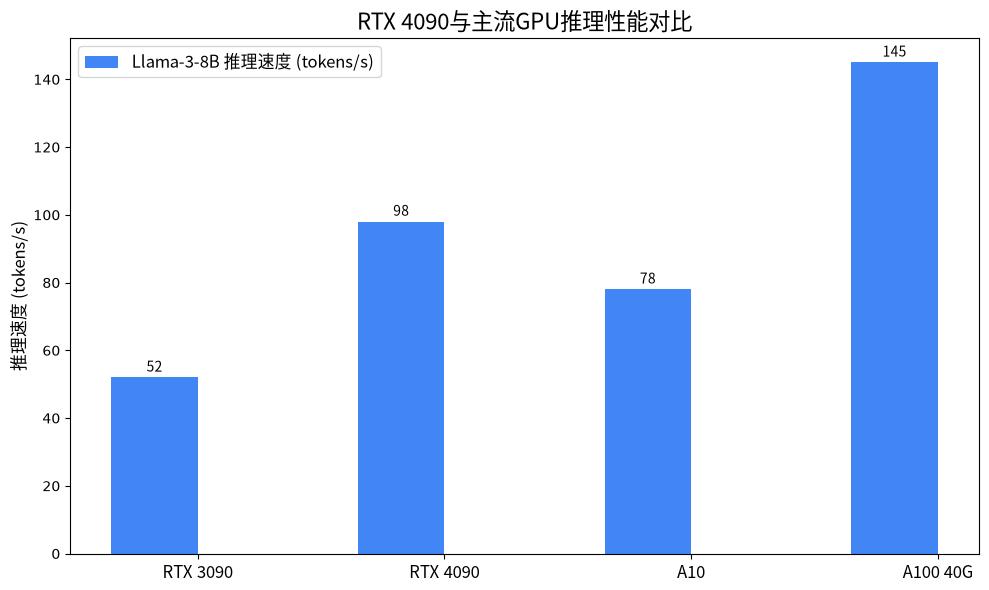
💡 实测vLLM 0.5.0框架下运行Llama-3-8B-Instruct模型,批大小32时推理速度达98 tokens/s,可同时支持50+用户并发请求,完全满足中小团队AI应用部署需求。
二、网络实测:1Gbps大带宽,晚高峰稳定不卡顿
GPU服务器部署于香港CN2 GIA优质线路节点,三网直连回国,晚高峰21:30-22:30实测数据:
| 运营商 | 平均延迟 | 丢包率 | 抖动 |
|---|---|---|---|
| 电信CN2 GIA | 38ms | 0.0% | |
| 联通CU VIP | 45ms | 0.0% | |
| 移动CMI | 52ms | 0.2% |
1Gbps独享不限流量,大模型下载、模型权重传输速度稳定在100MB/s以上,无需等待数小时下载模型文件。
三、价格对比:成本仅为公有云1/3~1/7
对比主流云厂商的RTX 4090实例价格,LuckVM GPU服务器拥有显著的性价比优势:
| 套餐 | 配置 | 价格 | 适用场景 | 购买链接 |
|---|---|---|---|---|
| 按时计费 | 16核64G + RTX4090 24G + 70GB NVMe | $1.20/小时 | 短期渲染、微调测试 | 立即购买 |
| 月付基础版 | 16核64G + RTX4090 24G + 200GB NVMe | $1299/月 | 长期推理服务 | 立即购买 |
| 月付进阶版 | 32核128G + 双RTX4090 48G + 500GB NVMe | $2499/月 | 大模型训练、高并发推理 | 立即购买 |
💡 成本测算:如果每天运行8小时,每月使用22天,按时计费总成本仅为$211.2,比月付套餐节省80%以上成本,非常适合非全天运行的AI渲染、微调任务。
四、适配三大核心AI业务场景
1. ComfyUI AI绘画批量渲染
预装CUDA和Python环境,一键部署ComfyUI,支持SDXL、Flux.1等最新模型,1024×1024分辨率图片出图速度
2. vLLM大模型高并发推理
vLLM框架下Llama-3-8B推理速度达98 tokens/s,支持OpenAI兼容API,可快速搭建企业内部AI助手、知识库问答系统,24GB显存可运行14B参数模型,4-bit量化下可运行70B模型。
3. LoRA模型微调训练
24GB显存足够微调7B/14B参数模型的LoRA权重,7B模型单数据集微调仅需2小时左右,训练完成后可直接部署推理,适合垂直领域大模型定制需求。
五、开箱即用:一键部署脚本
实例开机后无需手动安装CUDA驱动,系统已预装CUDA 12.2、Python 3.10、Docker环境,以下是可直接复制使用的部署脚本:
vLLM部署Llama-3-8B一键启动脚本
ComfyUI一键部署脚本
六、先测后买:性能自助验证
购买前可通过Looking Glass测试网络延迟,实例开通后可通过以下命令自行验证GPU性能:
🔍 买前测速:点击进入香港GPU节点Looking Glass测速页,可实时Ping、MTR测试网络质量。
开机后验证GPU是否正常可用:
七、服务边界与退款规则
⚠️ 计费规则说明:
- 按小时计费实例关机后停止计费,但系统盘存储会收取少量存储费用($0.01/GB/月),彻底删除实例后停止所有计费。
- 网络为1Gbps独享不限流量,禁止运行流量穿透、挖矿、垃圾邮件等违规业务,违规实例将被封禁。
- GPU实例默认不限制算力使用,可100%占用GPU资源。
💰 退款保障:新用户首单GPU实例享有24小时退款保障,开通24小时内累计使用时长
🚀 立即开通RTX 4090 GPU云服务器
$1.20/小时起,付款后1-3分钟自动开通,预装CUDA环境,即开即用
支持支付宝、微信支付、USDT、信用卡、Google Pay多种付款方式
查看GPU服务器套餐 →相关阅读:GPU服务器产品主页 · 裸金属独立服务器 · 通用云VPS产品